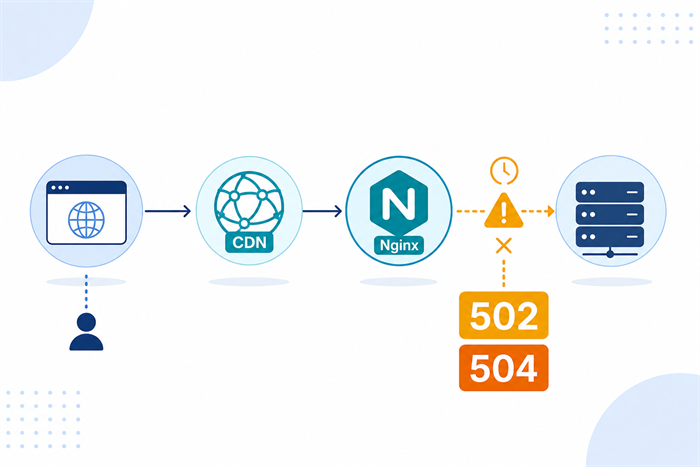
网站接了 CDN 之后仍然出现 502 或 504,说明请求没有完整走完“用户、CDN、源站”这段链路。502 通常是网关或代理收到了无效响应,504 表示网关或代理在等待上游时超时。本文按真实排查顺序拆解这两类错误,覆盖 CDN 日志、回源链路、Nginx 超时、应用阻塞、健康检查和故障恢复,适合负责网站、API、网关和云服务器运维的同学参考。
先给出排查路径:确认影响范围,再判断错误由 CDN、源站还是应用产生,接着查看对应日志和超时配置,最后处理容量、健康检查与重试策略。盲目重启服务器可能掩盖真正的瓶颈,还会让现场信息丢失。
一、先判断影响范围
排障时先确认四个问题:只有部分用户受影响,还是所有用户都失败;只有部分 URL 失败,还是整个域名都失败;错误是持续出现,还是流量高峰或发布后集中出现;源站是否同时存在 CPU、内存、磁盘 I/O、带宽或连接数异常。
可以用三个请求快速缩小范围:
curl -I https://www.example.com/
curl -I https://origin.example.com/health
curl -k -I https://源站IP/
第一条请求走完整 CDN 链路;第二条直接访问源站域名或负载均衡地址;第三条绕过证书和域名解析,验证源站服务是否仍在监听。如果直连源站正常,而 CDN 路径异常,重点查 CDN 回源配置、回源 Host、证书、端口和超时。如果直连源站也失败,重点查 Nginx、应用进程、数据库和后端依赖。
再看本地网络差异。某个地区、某个运营商或某个办公室集中失败,可能是链路质量、DNS 缓存或边缘节点回源路径问题。全站同时失败,则优先怀疑源站、证书、防火墙和安全组。
二、502 和 504 分别说明什么
502 Bad Gateway 表示代理收到了上游的无效响应,或者上游连接被异常断开。常见原因包括源站返回格式异常、Nginx 到 upstream 的连接被重置、回源证书校验失败、源站主动拒绝连接、后端进程崩溃后没有进程监听端口。
504 Gateway Timeout 表示代理等待上游超时。常见原因包括应用响应太慢、数据库锁等待、外部 API 阻塞、Nginx proxy_read_timeout 或 CDN 回源超时过短、后端队列积压、源站带宽或 CPU 达到限制。
两者经常交替出现。例如源站负载很高时,一部分请求等待到超时返回 504,另一部分请求因连接被重置返回 502。排查时不必纠结用户看到的是哪一个,应把两条链路的日志对齐。
三、把 CDN 日志和源站日志对齐
先取一条失败请求的时间、URL、状态码、请求 ID、客户端 IP、边缘节点和耗时,再拿这些字段去源站日志里找同一次访问。对齐之后,通常能落到三种情况。
第一种,CDN 有请求,源站也有请求并且状态码正常。这说明源站可能已经处理完成,但响应太慢,超过了 CDN 回源超时;也可能是响应头异常,被 CDN 判为无效。此时要对比 CDN 的回源耗时和源站的应用耗时。
第二种,CDN 有请求,源站没有请求。重点查回源协议、回源端口、回源 Host、DNS 解析、防火墙、安全组和源站白名单。如果回源使用 HTTPS,还要确认源站证书有效,且证书域名与回源 Host 匹配。
第三种,CDN 和源站都有请求,但源站状态码就是 502 或 504。如果源站前面还有 Nginx、网关或负载均衡,应继续向下一层追日志,直到找到真正超时或失败的节点。
四、Nginx 常见超时和错误
Nginx 反向代理常见错误日志包括 upstream timed out、connect() failed、no live upstreams、upstream sent too big header、SSL_do_handshake failed。不同日志指向不同配置。
连接后端超时,看 proxy_connect_timeout,它只控制建立 TCP 连接的时间。转发请求后等待后端响应的时间,看 proxy_read_timeout,默认值通常是 60 秒。向后端发送请求体的时间,看 proxy_send_timeout。这些时间是独立计时的,调大其中一个并不等于放宽整条链路。
示例配置:
proxy_connect_timeout 5s;
proxy_send_timeout 30s;
proxy_read_timeout 60s;
如果日志出现 upstream timed out,先记录后端实际处理耗时。后端接口确实需要更久,才考虑增加 proxy_read_timeout。后端本来就慢,盲目把超时调到 300 秒,只会让连接和线程更容易堆积,最终拖垮 Nginx。
如果出现 no live upstreams,查 upstream 的 max_fails 和 fail_timeout。max_fails 默认为 1,fail_timeout 默认为 10 秒;后端短暂失败后可能被暂时标记为不可用。健康检查异常或探测路径配置错误,也会造成所有后端被摘除。
如果出现 upstream sent too big header,查 proxy_buffer_size、proxy_buffers 和 proxy_busy_buffers_size。大 Cookie、长认证头或网关注入的响应头可能触发这个错误。修改前保留原配置,改完后用 nginx -t 验证,再 reload。
五、应用层的五个高发原因
第一,数据库慢查询和锁等待。请求看起来停在应用层,实际是在等待数据库。开启慢查询日志,确认可疑 SQL 的执行计划、索引和事务范围。
第二,外部 HTTP API 没有设置独立超时。支付、短信、风控、翻译、对象存储任何一个依赖阻塞,都可能把 Web 进程占满。应用侧要为每个外部调用设置连接超时、读取超时和最大重试次数。
第三,进程 worker 或线程池耗尽。PHP-FPM、Gunicorn、Node.js、Java 线程池、数据库连接池都属于常见瓶颈。观察排队时间、活跃请求数和等待队列,而不是只看 CPU 平均值。
第四,同步阻塞任务占用请求线程。导出报表、批量计算、图片压缩、邮件发送应移入后台队列,Web 请求只提交任务并返回任务 ID。
第五,内存不足或容器被系统杀掉。检查系统日志和应用日志中的 OOM、容器重启、进程退出记录。内存耗尽常表现为先变慢、再超时、最后端口无人监听。
六、CDN 侧要检查的配置
回源协议和端口必须与源站监听一致。源站只监听 443,CDN 配成 HTTP 80 回源,会得到连接拒绝;源站证书是正式域名,回源 Host 却写成 IP,HTTPS 校验也可能失败。
回源 Host 要按源站虚拟主机配置填写。Nginx 通过 Host 区分 server block,Host 错误时可能落到默认站点,返回 404、421、重定向,甚至后端异常。
回源超时要和源站能力匹配。静态文件、普通页面和长耗时 API 不应共用一套超时策略。API 需要 60 秒以上,就单独配置;普通页面则保持较短超时,避免错误长时间挂在用户面前。
自定义错误页可以改善体验,但不能替代修复。给 502 和 504 配置静态提示页,说明“服务暂时不可用,请稍后重试”,并保留状态码,便于客户端和监控系统识别。
七、恢复与降级顺序
生产事故里先保命,再找根因。建议按以下顺序处理:
第一,确认范围,只改真正异常的域名、路径或 upstream。
第二,摘掉故障后端。让负载均衡或 CDN 故障转移指向健康节点,避免继续把请求打进已经积压的机器。
第三,处理容量瓶颈。扩容应用 worker、数据库连接池或云服务器规格;如果带宽打满,先限制下载、爬虫和低价值流量。
第四,恢复关键路径。静态页、只读接口、缓存数据优先恢复,写操作可以延后。
第五,观察恢复曲线。确认错误率、P95 延迟、队列长度和 CPU 回落,不要只看页面能否打开一次。
第六,保留日志和配置快照。事故结束后再复盘超时、重试、健康检查和容量规划。
八、上线前的防复发清单
日志方面,保留 CDN 日志、Nginx access log 和 error log、应用结构化日志,并统一时间源。每条请求尽量带 request id、upstream 地址、upstream 响应时间和状态码。
监控方面,至少监控 HTTP 5xx 比例、P95 和 P99 延迟、回源失败率、缓存命中率、Nginx active connections、后端队列、CPU、内存、磁盘 I/O、带宽和数据库连接数。
配置方面,为每类接口明确超时;外部依赖必须有限流、熔断和降级;部署采用滚动发布并保留回滚版本;健康检查路径要检查真实依赖,但不把重依赖全部串进主探测。
容量方面,用压测确定单机容量,设置 worker、连接池和带宽告警阈值。发布前问一句:这次变更会不会增加响应时间、响应头大小、回源率或数据库压力?
结论
502 和 504 是链路症状,不是单点结论。排查时把 CDN 请求日志、Nginx error log、应用耗时和后端依赖放在同一条时间线上,先定位哪一段超时或断开,再决定改 CDN、Nginx 还是应用。恢复阶段优先摘除故障后端、保住关键路径,事后用统一的超时策略、日志字段和监控指标减少复发。
参考资料
MDN Web Docs:HTTP 502 Bad Gateway
https://developer.mozilla.org/en-US/docs/Web/HTTP/Status/502
MDN Web Docs:HTTP 504 Gateway Timeout
https://developer.mozilla.org/en-US/docs/Web/HTTP/Status/504
Nginx 文档:ngx_http_proxy_module
https://nginx.org/en/docs/http/ngx_http_proxy_module.html
AWS CloudFront 开发者指南:自定义错误响应
https://docs.aws.amazon.com/AmazonCloudFront/latest/DeveloperGuide/CustomErrorPages.html
AWS CloudFront 开发者指南:配额
https://docs.aws.amazon.com/AmazonCloudFront/latest/DeveloperGuide/cloudfront-limits.html