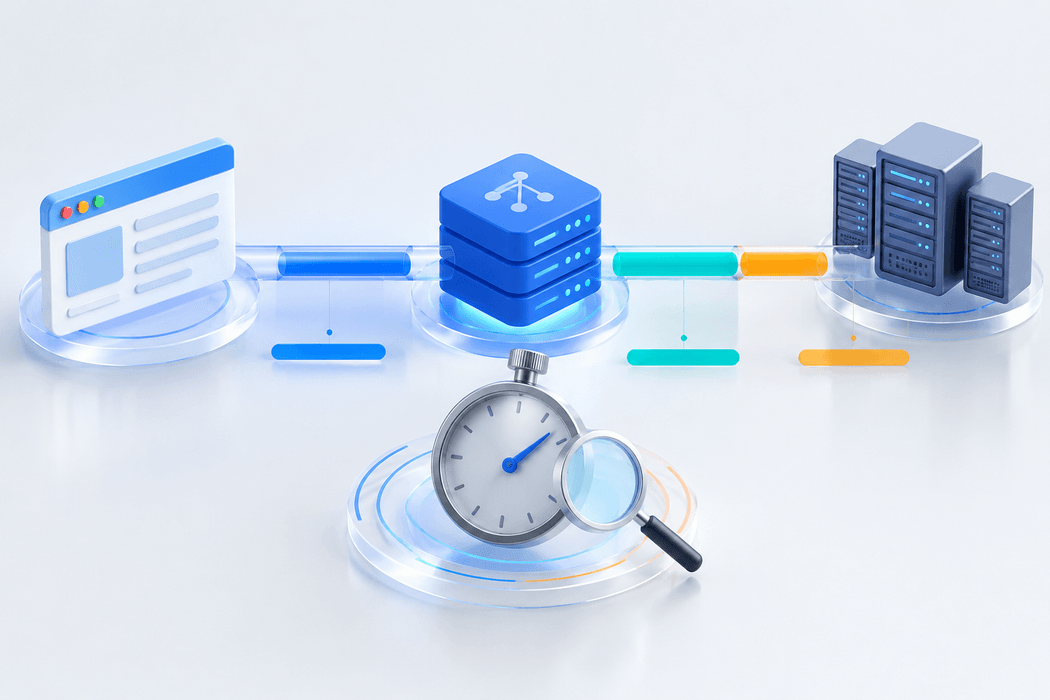
网站打开慢,Nginx 日志中的 request_time 很大,应用却说接口执行只用了很短时间。双方记录的范围可能不同:Nginx 的请求总时间包含读取客户端请求和向客户端发送响应的过程,上游响应时间则针对与后端交互的阶段。把两个数字直接相减,并不能得到一个准确的“网络耗时”。
排查应同时记录连接建立、响应头、完整上游响应和请求总时间,再结合请求类型、重试、缓存和缓冲方式判断。单个字段变大,通常只能缩小范围,不能直接确定某台服务器或某条 SQL 出了问题。
本文适用于常见 Nginx HTTP 反向代理部署。命令及配置为示例,需按实际版本、日志路径和业务流程调整;文中未连接生产服务器进行实测。
四个时间字段的范围不同
Nginx 官方文档将上游相关时间以秒表示,精度到毫秒。[1] 常见字段包括:
$upstream_connect_time:建立上游连接的时间。对 SSL 上游,还包含握手时间。$upstream_header_time:接收上游响应头的时间。$upstream_response_time:接收上游响应的时间。$request_time:从读取到客户端请求的首批字节开始,到向客户端发送最后字节之后记录日志时的请求处理时间。[2][3]
这些值不能当成几个互不重叠的阶段再相加。尤其不能将 header_time 直接解释为后端代码执行时间;连接、排队、协议交互及后端输出方式都可能影响它。
request_time 也不等于浏览器完整页面加载时间。一个页面包含多个资源,浏览器还存在 DNS、连接、缓存和渲染等环节;如果前面有 CDN,源站 Nginx 面向的客户端通常是 CDN 节点,无法单靠源站日志观察最终访客的完整下载过程。
用同一条日志保留请求上下文
下列配置展示最小化的计时记录思路。log_format 应放在 http 上下文,access_log 需放在预期的服务器或位置作用域中。示例路径必须替换为实际可写目录。
log_format timing '$time_iso8601 method=$request_method uri=$uri '
                  'status=$status bytes=$body_bytes_sent '
                  'rt=$request_time upstream="$upstream_addr" '
                  'us="$upstream_status" uct="$upstream_connect_time" '
                  'uht="$upstream_header_time" urt="$upstream_response_time"';

access_log /var/log/nginx/timing.log timing;
$uri 不包含完整查询字符串,可以减少把令牌等参数写入日志的风险,但 URI 路径本身仍可能包含用户信息,内部重写也可能改变它。若需要关联原始地址,应经过隐私评估再选择字段,不要直接记录 Authorization、Cookie 或请求正文。
启用新日志前备份配置,确认磁盘容量、目录权限、轮转与保留策略,执行 nginx -t 通过后按现有流程平滑加载。语法检查通过不能保证日志内容符合预期,应实际发起一个已知请求,确认新记录出现且字段正确。
高流量环境可在短窗口或受控范围采集,避免为了定位慢请求又造成日志写入压力。回退时恢复本次日志配置并复查加载,不应顺手删除其他访问日志规则。
连接耗时偏高,先核对具体上游
upstream_connect_time 明显变大时,检查对应的 $upstream_addr,确认连接的是哪一个后端实例。然后结合后端监听、连接队列、网络丢包、防火墙及 TLS 配置排查。
连接成功并不代表后端立即开始执行应用逻辑。连接时间短、响应头迟迟不到,也可能是应用队列或依赖服务在等待。单看“CPU 不高”不足以排除后端瓶颈,锁等待、数据库连接池和外部接口都可能让请求停住。
复用连接与新建连接的条件不同,比较时应按目标上游、协议、请求类型和流量时段分组。计时精度有限,显示 0.000 也不能解释成没有任何耗时。
响应头慢与响应体慢应分开看
连接耗时较低而响应头耗时较高时,优先把日志时间与应用接收请求、数据库调用和外部依赖记录对齐。服务器时钟与时区需要一致,跨系统关联最好使用已有的请求标识;请求标识本身不应包含凭证或用户隐私。
响应头很快到达,但完整上游响应时间较长时,可能是后端持续生成内容、传输大响应,或采用流式输出。需要核对响应大小、业务类型以及后端实际发送过程。
不要把 $upstream_response_time - $upstream_header_time 当作精确的“纯网络下载耗时”。它包含后端生成后续内容和传输等过程,异常结束、多次尝试和输出策略也会改变解释条件。
例如文件下载、SSE 或长轮询本来就可能持续很久。按普通 JSON 接口的阈值报警,会把预期的长连接误判成性能故障。WebSocket 升级后的长期连接也应单独分析。
总时间高、上游时间低,不一定是客户端网速差
这种组合需要检查请求体上传、向下游发送响应、限速、代理缓冲和磁盘临时文件等环节。慢上传在常见的请求缓冲方式下,可能使 Nginx 等待接收请求体,而后端处理阶段仍很短。
响应缓冲方式同样会改变耗时关系。启用代理缓冲时,Nginx 可以在一定条件下先接收上游数据,再向较慢的下游发送;关闭缓冲或响应很大时,下游读取速度也可能反过来影响上游数据接收。
因此,request_time 与 upstream_response_time 的差值无法统一命名为“客户端耗时”。两段过程可能交叠,是否缓冲、是否落盘及上下游流量控制都需要纳入判断。
有 CDN 或负载均衡时,还应查看边缘到访客的指标。源站向 CDN 很快发送完成,并不能证明手机用户下载也快。
多个数值和横线不能直接按浮点数处理
Nginx 文档说明,与多个上游交互时,上游时间可能按逗号分隔;不同上游组之间的内部跳转可用冒号分隔。地址和状态也需要按对应结构一起解释。[1]
日志分析工具如果只取第一个值,可能漏掉失败重试;把整串值强行转换为单个数字,也可能产生错误统计。应保留尝试序列,区分每次上游交互和整个客户端请求。
没有访问上游、命中本地处理路径或缓存时,字段可能没有可用计时值,日志中常见横线占位。横线不是零,也不能统一代表后端非常快;应结合路由、缓存状态和实际部署确认。
超时、499、502 或 504 请求中的上游计时可能对应一次未正常完成的尝试,不能直接并入成功请求的接口耗时分布。状态码、尝试次数和响应大小应与时间一起保留。
从样本到修复,避免直接放大 timeout
先从同类请求中抽取慢样本和正常样本,按 URI、请求方法、状态、上游实例和响应大小比较。含资源 ID 的路径可在分析侧按路由模板归类,避免一个 URL 一个分组导致统计失真。
若已有足够样本,可以观察分位数和错误率,不宜仅凭平均值判断。记录统计窗口和样本量,长连接、下载及失败请求分开处理。本文没有提供通用阈值,不同业务的正常时延差异很大。
确认问题层级后再修复。例如连接阶段异常,需要核对网络与后端接入;后端首部等待增加,需要追踪应用和依赖;大响应或下游拥塞,需要检查输出与缓冲设计。单纯延长代理超时可能让更多请求堆积,并掩盖容量或依赖故障。
任何缓冲、超时或连接参数变更都应记录原值,先在受控流量中验证,再决定扩大范围。不能为了让日志好看而停止记录失败请求。
验收需要观察同一种业务负载
修复后保留同样的日志字段,比较相近负载下的连接、响应头、上游完整响应和请求总时间,同时核对成功率、响应内容及后端资源占用。接口返回更快但内容缺失,不属于性能恢复。
如果修改日志配置只为短期诊断,结束后恢复原采集范围,按保留策略处理文件。若修改了业务参数,回退时只撤销本次变更,再检查配置、加载和原始问题路径。
能把一条慢请求对应到具体上游、失败阶段和后端记录,才有足够证据确定修复方向。单个耗时数字只能提供线索。
参考资料
资料核验日期:2026 年 10 月 30 日。文档定义需结合实际 Nginx 版本和代理模块使用方式理解。
[1] Nginx 官方:upstream 模块变量与多上游计时。https://nginx.org/en/docs/http/ngx_http_upstream_module.html
[2] Nginx 官方:日志模块与请求时间示例。https://nginx.org/en/docs/http/ngx_http_log_module.html
[3] Nginx 官方:核心模块内置变量 request_time。https://nginx.org/en/docs/http/ngx_http_core_module.html