执行 docker stop 后,终端迟迟没有返回;等了一会儿容器终于停下,应用日志却没有正常退出的记录。遇到这种情况,先别急着把等待时间调大。需要先查清楚:应用是在处理剩余任务,还是根本没收到停止通知。
本文以 Linux 容器、Docker Engine 和 Docker Compose 为主。命令中的 app、web 都是示例名称,请替换成实际对象。以下排查不包含线上实测结果;停止、重建和故障验证应放在测试环境,或安排在已获批准的维护窗口。
docker stop 等的是什么
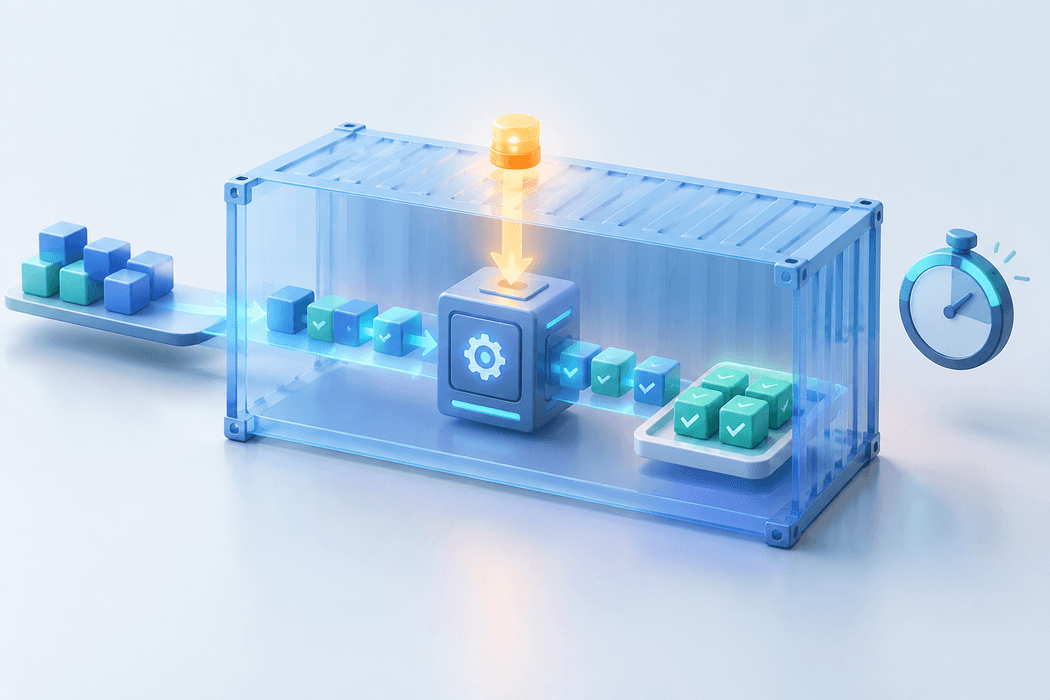
Docker 停止容器时,会先向容器的主进程发送停止信号,等待一段宽限时间;如果主进程仍然没有退出,再发送 SIGKILL 强制结束。
未单独配置时,停止信号通常是 SIGTERM。镜像的 STOPSIGNAL、创建容器时的 --stop-signal,以及 Compose 的 stop_signal 都可能改变它。排查时应以当前运行容器和实际部署配置为准。
等待时间也不总是十秒。Docker 官方文档给出的未配置默认值是 Linux 容器 10 秒、Windows 容器 30 秒;创建容器时可以设置默认停止时间,单次 docker stop --timeout 可以覆盖本次等待。Compose 还有自己的 stop_grace_period 配置。
如果每次都接近同一个上限才结束,值得检查是否走到了强制终止;但仅凭时间相近,还不能认定信号丢失。应用也可能确实需要较长时间完成当前请求。
先检查运行对象,不要直接反复重启
先收集现状,避免一次重建把原来的进程关系和日志线索都换掉:
docker inspect --format 'Path={{.Path}} Args={{json .Args}} StopSignal={{.Config.StopSignal}}' app
docker inspect --format '{{json .State}}' app
docker top app
docker logs --since 15m --tail 200 app
Path 和 Args 有助于确认实际启动入口,docker top 用于观察进程关系。不同平台的进程显示方式可能不同;需要核实容器内 PID 时,可以在具备相应工具和权限的测试容器中进一步查看。
State 中的退出码、结束时间和 OOMKilled 可以辅助判断。容器仍在运行时,这些字段不能当作本次停止的结果。
注意两种常见误读:
- 退出码 137 常与 SIGKILL 有关,但不能单独证明发生了 OOM。还应结合
OOMKilled、宿主机事件和内核日志判断。 - 退出码 143 常见于 SIGTERM 终止,也不能证明请求已经处理完、数据已经落盘。应用也可能自行选择退出码,仍需查看退出日志和业务状态。
日志里没有“shutdown”同样不是定论。有的程序没记录退出过程,有的日志还没刷新就被中止。最好同时检查信号处理配置、请求完成情况和队列消费结果。
PID 1 为什么会影响停止
容器的主进程通常是容器 PID 命名空间中的 PID 1。Docker 把停止信号交给这个入口,而不是替应用逐个通知所有子进程。Linux 对 PID 1 的信号默认行为也有特殊规则,不能假设一个未实现退出处理的程序一定会按普通进程的方式结束。
常见问题出现在 shell 形式的入口:
ENTRYPOINT /usr/local/bin/my-server --config /etc/app/config.yml
它通常会经过 /bin/sh -c。如果 shell 留在主进程位置,应用在下层运行,而 shell 没有正确转发信号,应用便可能一直等到强制终止。
对于直接启动单个应用的镜像,可以采用 exec 形式:
ENTRYPOINT ["/usr/local/bin/my-server"]
CMD ["--config", "/etc/app/config.yml"]
这能减少中间 shell,但不会自动给应用补上优雅退出逻辑。程序仍然需要识别停止信号,并停止接收新任务、处理已有任务、释放资源。
入口脚本最后启动服务时,检查有没有 exec
有些容器需要入口脚本先生成配置或检查目录。脚本不必全部移除,但最后启动单个前台服务时,可以用 exec 替换当前 shell:
#!/bin/sh
set -e

# 在这里完成必要且有限时的初始化。
exec /usr/local/bin/my-server "$@"
exec 之后,应用接替脚本成为主进程,更容易直接收到 Docker 发出的停止信号。
这个写法适用于脚本最后只负责启动一个前台服务的情况。如果脚本还要管理多个后台进程、执行收尾操作或收集子进程状态,简单加一个 exec 可能破坏原来的生命周期。此时需要明确设计信号转发、子进程等待和退出顺序,或使用合适的进程管理方案。
不要把应用丢到后台后再用 tail -f /dev/null 保活。这样主进程的退出与应用状态脱节,停止和健康检查都会变得难以解释。
init 能帮忙,但不能代替应用收尾
Compose 的 init: true 会为容器加入一个轻量 init 进程,用于转发信号和回收子进程。对于会派生子进程的工作负载,这有助于改善进程管理。
它不会替数据库完成事务,也不会替队列消费者确认消息,更不会让应用自动理解 SIGTERM。若应用没有退出处理,加入 init 后仍可能等到宽限时间结束。
可以把问题拆成三层检查:Docker 有没有发送预期信号;入口和中间进程有没有把信号交给应用;应用收到后有没有完成自己的退出流程。只有最后一层完成,业务上的优雅退出才算有依据。
Compose 的停止配置怎么写
下面只展示相关配置片段,不是可直接替换现有部署的完整文件:
services:
  web:
    image: your-app:tested-tag
    init: true
    stop_signal: SIGTERM
    stop_grace_period: 30s
your-app:tested-tag 是占位符。init 是否需要开启、停止信号用什么、等待多久,都应按应用文档和测试结果决定。某些服务使用其他信号进行有序退出,不能为了统一配置强行改成 SIGTERM。
三十秒只是示例。合理的宽限时间应覆盖正常排空和收尾的上限,同时符合部署、负载均衡或编排平台的外层终止期限。内层还在等待,外层已经强制结束,延长容器配置也没有用。
修改配置后,现有容器不一定自动采用新设置。先检查实际生效配置;docker compose config 可以辅助检查,但其输出可能包含解析后的环境值,不要原样贴到公开工单。
入口脚本、镜像或容器创建参数变更通常需要重新构建或重建才能生效。重建前确认持久化卷、镜像版本和回滚方法,不要把 docker compose down -v 当作应用停止问题的排查步骤。
用一次可观察的停止验证修复
在测试环境或已批准的维护窗口,可以对一个明确对象验证:
# 会停止该容器;不要对未确认的生产对象执行。
time docker stop --timeout 30 app

docker inspect --format '{{json .State}}' app
docker logs --since 5m --tail 200 app
这条命令只改变本次等待上限,不会把三十秒写成容器以后一直使用的默认配置。停止后的容器也不会因为测试结束就自动恢复服务,验证前要准备恢复步骤。
观察重点不只是命令用了几秒。应用应当能记录收到退出通知、停止接受新工作、完成或明确取消在途任务,以及最终退出。对 Web 服务,检查摘流后的请求是否仍被错误送入;对队列消费者,检查是否停止领取新消息、未完成消息是否可重试;对有写入的服务,检查事务与持久化边界。
有长连接、流式响应或长任务时,要明确等待上限和取消策略。无限等待可能让部署一直卡住;直接缩短超时,又可能切断尚未完成的工作。
如果在轻载环境成功,还应在代表性负载下复验。记录镜像版本、停止信号、宽限时间、实际耗时和业务结果,避免把一次空闲退出当成修复完成。
该调超时,还是改启动方式
如果应用根本没收到信号,先修入口、转发链或信号选择;如果收到信号后继续接新任务,先修摘流与应用退出逻辑;如果已经正常排空,只是合理任务确实超时,再评估业务截止时间与宽限期。
不要用 kill -9 掩盖问题,也别靠不断拉长停止时间“治好”固定等待。真正有用的验收结果是:停止过程可以解释,业务收尾有证据,恢复和回滚路径清楚。
参考资料
以下为 Docker 官方文档,核对日期:2026-10-30。不同版本和平台的参数支持可能不同,执行前请结合本机帮助与应用文档确认。