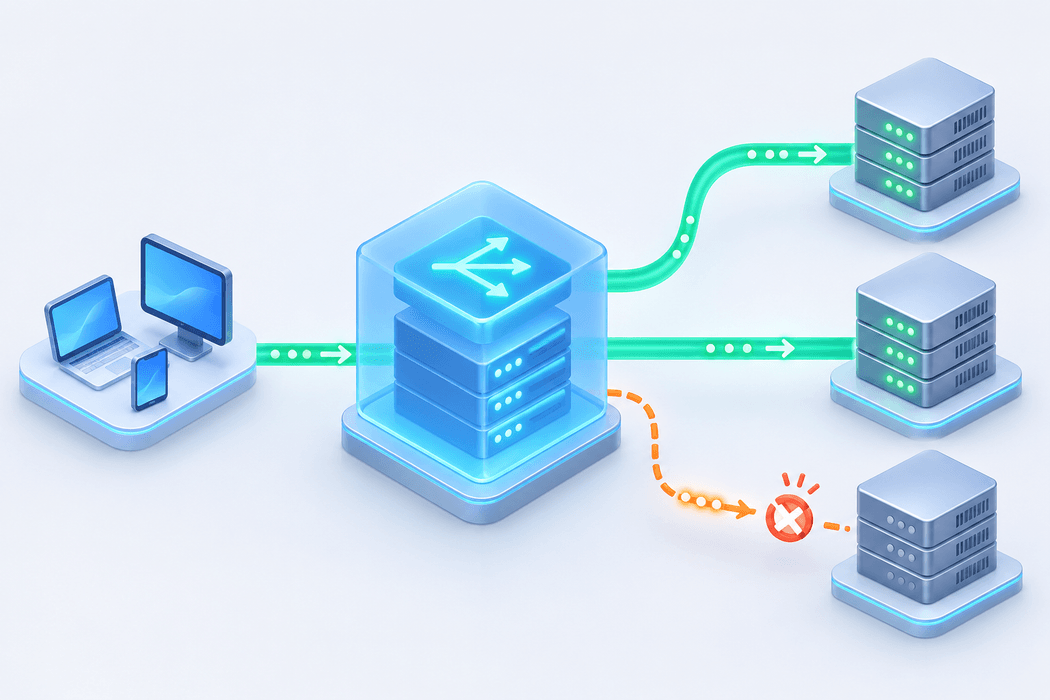
网站前端显示 502 Bad Gateway,Nginx error log 里却只留下一行 upstream 连接失败。这个状态码说明代理没有从上游拿到可用响应,但原因可能是后端进程没启动、监听地址写错、Unix Socket 权限不足、容器网络不通,或者后端刚好在重启。只改 Nginx 超时参数,通常解决不了连接根本建立不起来的问题。
Nginx 的 proxy_pass 会把请求转发给配置的上游;具体连接失败信息应以 error log 为准。本文从“请求是否命中正确代理块、Nginx 实际连向哪里、上游是否能独立响应、应用与权限是否正常”四层排查。示例适用于常见 Linux Nginx 反向代理,Docker、systemd、PHP-FPM 和 Unix Socket 场景会分别说明。
先从 error log 区分 502 类型
先记录发生时间、访问路径和对应的错误行:
sudo tail -n 100 /var/log/nginx/error.log
sudo journalctl -u nginx --since '10 minutes ago' --no-pager
不同错误指向的方向不同:
connect() failed (111: Connection refused):目标地址可到达,但目标端口没有接受连接,常见于后端未启动、端口写错或只监听了其他地址。No such file or directory:配置使用 Unix Socket,但 Socket 文件不存在,常见于服务未启动、路径不一致或重启后路径变化。Permission denied:Nginx worker 用户无法访问 Socket 所在目录或文件,也可能是 SELinux 等安全策略阻止访问。upstream timed out:连接或读取阶段超过对应超时,需要结合connect、read的上下文判断;后端慢和后端完全不可达不是同一个问题。upstream prematurely closed connection:上游在返回完整响应前主动关闭,需查看应用崩溃、超时、协议和资源限制。
一条 502 日志不能说明所有访问都失败。保留请求时间和上游地址,观察是单个后端、某个路径还是全部站点异常。
先确认请求命中了哪一个代理配置
配置改过但请求仍返回 502,可能命中了另一个 server 或 location。先展开当前 Nginx 配置:
sudo nginx -T > /tmp/nginx-full-$(date +%F-%H%M%S).conf
sudo grep -n -E 'server_name|listen|location|proxy_pass|upstream' /tmp/nginx-full-*.conf
用正确的 Host 测试本机入口:
curl -i -H 'Host: example.com' http://127.0.0.1/
curl -k -i --resolve example.com:443:127.0.0.1 https://example.com/
第二条命令保留域名用于 TLS SNI,同时将连接送到本机。若网站经过 CDN 或负载均衡,源站本机测试与公网请求并不等价,还要确认边缘到源站的 Host、端口和协议。
注意 location 的匹配规则。一个更具体的路径可能使用了另一条 proxy_pass,而你修改的是通用块。proxy_pass 是否带 URI 也会影响转发路径;改动前记录后端实际收到的 URI,避免把路径重写问题误判为连接故障。
proxy_pass 写的是端口,还是 Unix Socket
TCP 上游示例:
location /api/ {
    proxy_pass http://127.0.0.1:9000;
    proxy_http_version 1.1;
    proxy_set_header Host $host;
    proxy_set_header X-Real-IP $remote_addr;
    proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
    proxy_set_header X-Forwarded-Proto $scheme;
}
核对后端实际监听:
sudo ss -lntp | grep -E ':(9000|8080)\b'
curl -i --max-time 5 http://127.0.0.1:9000/health
这里的 /health 只是示例路径,应用可能没有该接口。若本机直接访问 9000 已经失败,先修复应用或监听配置,再看 Nginx。
Unix Socket 示例:
location /api/ {
    proxy_pass http://unix:/run/example/app.sock:
    proxy_set_header Host $host;
}
不同版本和部署工具对 Socket URI 的写法要按实际配置核对,不能把 TCP 端口和 Socket 路径混在一起。检查文件和每一级目录权限:
sudo stat /run/example/app.sock
sudo namei -l /run/example/app.sock
ps -eo user,pid,cmd | grep '[n]ginx: worker'
Nginx worker 需要能够穿过 Socket 的父目录,并对 Socket 有必要的访问权限。把 Socket 改成 chmod 777 不是稳妥修复;应让应用服务和 Nginx 使用合理的用户组、目录权限和运行目录。systemd 管理的服务还可能在重启时重新创建 Socket,手工修改权限会在下一次启动后消失。
后端绑定地址写错也会导致 502
后端监听 127.0.0.1:9000 时,宿主机上的 Nginx 可以访问;如果 Nginx 在另一个容器里,那个容器的 127.0.0.1 指向自己,不能指向宿主机或应用容器。容器场景应使用共享网络中的服务名和容器端口:
location /api/ {
    proxy_pass http://app:9000;
}
app 必须是 Nginx 容器可解析、且与之加入同一 Docker 网络的服务名或别名。不要把宿主机发布端口和容器内部端口混为一谈。
如果 Nginx 在宿主机、后端在容器中,127.0.0.1:9000 是否可用取决于容器端口有没有发布到宿主机回环地址。可以从宿主机和容器内分别测试:
docker ps --format 'table {{.Names}}\t{{.Ports}}'
docker network inspect app_network
curl -i --max-time 5 http://127.0.0.1:9000/health
容器端口没有对宿主机发布时,宿主机不能凭空访问容器内部端口;发布地址、网络模式和安全边界要按部署设计处理。为排查临时把数据库或管理端口暴露到公网,会制造新的风险。
systemd 后端启动失败时,别只看 Nginx
如果后端由 systemd 管理,查看服务状态和最近日志:
sudo systemctl status example-app --no-pager
sudo journalctl -u example-app -n 100 --no-pager
sudo systemctl show example-app -p ActiveState -p SubState -p MainPID
常见原因包括环境变量只在交互式 Shell 中存在、工作目录不对、应用用户无权读取文件、端口已被占用、数据库尚未准备好,或服务启动后马上退出。Nginx 只是最后报告连接失败的一方。
确认应用实际监听与配置一致:
sudo ss -lntp
sudo lsof -nP -iTCP:9000 -sTCP:LISTEN
没有 lsof 时使用 ss 即可。检查结果不要只看端口号,还要看监听地址、进程 PID 和启动时间。后端监听 IPv6、Nginx 却连接 IPv4,或反过来,也可能造成看似奇怪的连接失败。
应用重启期间出现短暂 502,需要结合发布策略处理。可以使用优雅重启、健康检查、连接排空和多实例 upstream;不能用无限增加 proxy_connect_timeout 掩盖没有可用后端的问题。
upstream 多节点时看失败的是哪一台
配置多个后端时:
upstream app_backend {
    server 127.0.0.1:9000;
    server 127.0.0.1:9001;
}

server {
    listen 80;
    server_name example.com;

    location / {
        proxy_pass http://app_backend;
        proxy_set_header Host $host;
    }
}
逐个测试 9000 和 9001,确认每个节点都能返回符合预期的响应。一个节点停止服务时,Nginx 的失败转移行为还受连接阶段、重试配置和请求方法影响,不能简单认为所有请求都会安全重试。带写入操作的请求尤其要避免因重复转发造成副作用。
生产环境可以为 upstream 配置健康检查或使用外部负载均衡,但具体能力取决于 Nginx 版本、商业版或外围组件。文章示例不把额外模块能力当作开源版本默认功能。
修改配置后的安全应用顺序
保留修改前配置,先检查语法,再 reload:
sudo cp -a /etc/nginx/sites-enabled/example.conf /etc/nginx/sites-enabled/example.conf.bak-$(date +%F-%H%M%S)
sudo nginx -t
sudo systemctl reload nginx
执行 reload 后立即查看服务状态和日志,并用本机 Host 测试。若结果异常,恢复备份、重新 nginx -t 后再 reload。不要直接 kill -9、删除 PID 文件或执行会清空其他站点配置的命令。
配置变更若由容器、Ingress 或管理面板生成,应修改持久化源文件并按对应控制器方式发布;直接改生成文件,下一次同步可能恢复原样。每次变更记录目标 upstream、监听端口、Socket 路径和验证结果,之后出现 502 更容易对照。
一套从外到内的验证清单
- 从错误日志确认是拒绝连接、Socket 不存在、权限、超时还是上游提前关闭。
- 用
nginx -T确认请求命中的server、location和proxy_pass。 - 在 Nginx 所在网络命名空间直接访问上游地址或服务名。
- 检查后端监听地址、进程状态、Socket 权限和应用日志。
- 多节点逐一测试,确认没有单个坏节点。
- 通过本机入口、源站域名和公网域名分别验证,区分 CDN 或负载均衡影响。
- 保留回滚配置,不用增加超时或开放公网端口替代真正修复。
当上游能独立返回、Nginx 配置命中正确块、reload 成功且错误日志消失,才算完成一次可验证的修复。浏览器重新打开页面只能说明某一次请求成功,不能替代分层检查。
参考资料
资料核验日期:2026 年 11 月 10 日。示例路径、端口和服务名需按实际环境替换。