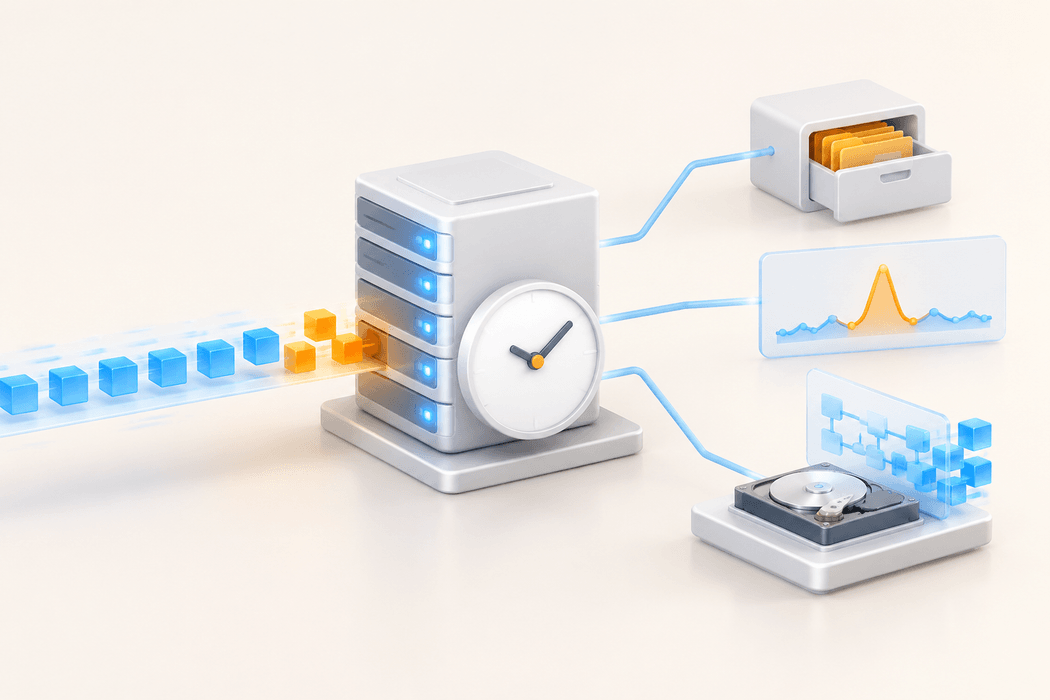
接口平时很快,偶尔一次却等上几秒,应用日志显示耗时集中在 Redis 调用。但查看 Redis 的 CPU 和内存,数值又不高。这类故障需要对齐发生时间,分别检查客户端等待、命令执行、服务器内部停顿和持久化活动。故障过后的一张资源截图,很容易错过短暂峰值。
先保留现场,记录具体实例、时间范围、命令类型与客户端超时。不要一开始就重启 Redis、清空慢日志或手动触发备份,这些操作可能丢失线索,或给正在承压的实例增加工作。
本文面向常见 Redis 开源服务端和 Linux 运维环境。命令默认连接本机 6379,需替换为目标实例;使用 ACL、TLS 或托管服务时,按现有安全方式鉴权,并核对命令权限。示例没有在读者生产环境执行,也不构成性能实测。
先把客户端耗时与服务器执行耗时分开
应用记录的一次 Redis 调用,可能包含连接池等待、建立连接、发送请求、服务器处理、返回数据和客户端解析。SLOWLOG 记录的范围更窄,主要是服务器执行命令的耗时,不包括读取请求和发送回复等客户端通信时间。[1]
因此,应用等了两秒、SLOWLOG 没有对应条目,并不能直接证明 Redis 没问题。也不能仅凭慢日志里的一个耗时值,解释整个请求为什么超时。
排查前先整理几项信息:
- 发生卡顿的是哪一个节点,是否刚好发生主从切换或连接重建。
- 所有客户端都慢,还是只有某台应用服务器慢。
- 小型读写也慢,还是某类命令、大结果集或脚本才慢。
- 延迟发生在请求开始前、执行期间,还是返回较大数据时。
在应用所在网络短时间运行 PING 延迟采样,可以增加一条对照:
redis-cli -h 127.0.0.1 -p 6379 --latency
替换连接地址后运行,采样结束按 Ctrl+C。这个模式显示 PING 往返延迟,不能代替真实业务命令的耗时,也不提供整套业务的 p99。若在 Redis 主机本地正常,而应用侧明显慢,应继续查网络、连接池和客户端负载;两侧同时抖动,再结合服务器内部记录判断。[6]
用 SLOWLOG 找到执行时间较长的命令
先读取现有阈值和记录,不急着修改:
redis-cli CONFIG GET slowlog-log-slower-than
redis-cli CONFIG GET slowlog-max-len
redis-cli SLOWLOG LEN
redis-cli SLOWLOG GET 20
slowlog-log-slower-than 的单位是微秒。例如 10000 表示约 10 毫秒;负数关闭慢日志,0 会记录所有命令。slowlog-max-len 限制保留条数,SLOWLOG LEN 也只是当前保留数量,不能当作从启动以来的慢请求总数。[1]
查看命令、参数规模、耗时与时间戳,把它们和应用超时记录对齐。时间戳需要换算到同一时区。慢日志可能包含业务键名、参数和客户端标识,导出前应脱敏,不要把完整结果直接贴到公开工单。
如果相同命令持续出现,检查数据规模、一次返回的条数、脚本工作量和调用方式。例如,范围查询没有限制返回量、读取很大的值、脚本在一次调用中处理过多数据,都需要从具体请求入手。不能仅凭命令名字就认定存在故障。
调整阈值前记录原值,并按实例负载确定采样窗口。把阈值设为 0 可能增加记录工作,也会很快挤掉旧条目;SLOWLOG RESET 会删除现有慢日志,不适合作为排查的起点。
用延迟监测补充内部事件线索
Redis 的延迟监测会为部分内部事件记录超过阈值的样本。它与 SLOWLOG 的观察对象不同,适合补充命令执行之外的服务器停顿线索。[2]
先查看配置和已有结果:
redis-cli CONFIG GET latency-monitor-threshold
redis-cli LATENCY LATEST
redis-cli LATENCY DOCTOR
latency-monitor-threshold 使用毫秒,和慢日志阈值的微秒不要混淆。值为 0 表示关闭监测。没有结果可能是未启用、样本未达到阈值或事件未被捕获,不能直接写成“实例无延迟”。
确需临时开启时,可以在授权范围内将阈值设为一个适合当前故障的数值。例如:
redis-cli CONFIG SET latency-monitor-threshold 100
100 毫秒只是诊断示例,无法捕获低于这个阈值的停顿。变更前保存 CONFIG GET 返回的原值;采样结束后,将该选项恢复为原来的数值。不要顺手执行 CONFIG REWRITE,把临时诊断配置永久写入。
LATENCY LATEST 返回事件名称后,可以按实际名称查看历史,例如确实出现 fork 事件时:
redis-cli LATENCY HISTORY fork
LATENCY DOCTOR 的文字建议可以帮助形成排查方向,但仍需要结合实例和宿主机证据。托管 Redis 可能限制 CONFIG 或 LATENCY 命令,应使用服务商提供的对应监控,不要尝试绕过管理权限。
把卡顿时间与 RDB、AOF 活动对齐
读取持久化和统计信息:
redis-cli INFO persistence
redis-cli INFO stats
常见可用字段包括 rdb_bgsave_in_progress、aof_rewrite_in_progress、rdb_last_bgsave_status、aof_last_bgrewrite_status,以及 latest_fork_usec。字段是否存在取决于版本和持久化模式。[4]
latest_fork_usec 的单位是微秒,它描述最近一次 fork 的耗时,不是每次请求的耗时。RDB 后台保存、某些 AOF 重写流程会涉及后台子进程;创建子进程的 fork 阶段可能使主进程短暂停顿。数据规模、内存页表、写入量与宿主机条件都会影响表现。后台保存期间还要留意写时复制带来的额外内存压力。[3][5]
不过,看到 BGSAVE 正在运行,不能据此认定整个保存期间 Redis 都停止服务。需要把 fork 耗时、延迟事件和应用异常时间放在一起比较。
AOF 启用时,磁盘同步也值得检查。观察 aof_delayed_fsync 等可用字段时,要看故障窗口内是否新增,而不是把一个累计数值直接当成当前故障。不同 fsync 策略涉及性能与数据持久性的取舍,不能为了降低延迟就随意关闭持久化。[3][4]
如果需要调整备份、重写或持久化策略,应先确认数据恢复目标、主从拓扑、内存余量和磁盘性能。不要在诊断中手动执行 SAVE;也不要为“复现一下”而在高峰期反复触发 BGSAVE 或 BGREWRITEAOF。
宿主机需要连续采样
在有权限的 Linux 主机上,结合已有监控或可用工具短时间观察:
vmstat 1 10
iostat -xz 1 10
工具不存在时,按发行版流程安装或使用云监控,不要在故障期间盲目升级系统组件。不同工具的首轮输出可能是启动以来的平均值,应结合后续采样解读。
关注 CPU 排队、虚拟机 CPU 争用、磁盘等待、交换活动和可用内存。如果卡顿恰好伴随 fork、后台保存和磁盘延迟升高,可以继续检查持久化文件所在磁盘、同盘备份任务和云盘性能限制。时间相关只能提示方向,还要通过调整单一因素后的复测验证。
容器部署还应检查 CPU 配额和内存限制。主机整体资源充足,不能保证 Redis 容器没有受到限制。共享主机上的其他任务也可能只在很短的窗口内占用资源。
不建议在此时长期开启 MONITOR,或对整个键空间做高强度扫描。诊断命令本身也有开销,应控制频率、范围和持续时间。
按观察结果选择下一步
| 观察结果 | 后续动作 |
|---|---|
| 同类命令反复进入慢日志 | 检查数据规模、返回量、脚本和调用方式 |
| 延迟事件与 fork 时间吻合 | 核对持久化计划、内存和宿主机条件 |
| AOF 同步异常与磁盘抖动同时出现 | 核对磁盘性能、同盘任务和持久化策略 |
| 应用侧慢,本机 PING 较稳定 | 检查客户端连接池、网络和应用负载 |
| 仅某个节点抖动 | 检查该节点资源、角色、持久化与切换记录 |
每次只调整一个明确因素,保存修改前的配置值,并安排与影响相匹配的变更窗口。客户端连接池或超时参数改动后,也要观察是否把短暂卡顿变成了更多积压和重试。
验收使用相近负载和相同时间范围,比较应用延迟分位数、超时数量、慢日志新增记录、内部延迟事件及宿主机指标。恢复临时诊断阈值后再观察一段时间;如果只在备份窗口复发,就把验证覆盖到那个窗口,而不是凭几次 PING 正常结束排查。
官方参考资料
资料核验日期:2026 年 11 月 19 日。命令和字段以部署版本、托管平台权限为准。
- Redis:SLOWLOG GET——慢日志采样范围、阈值与记录。
- Redis:Latency monitoring——事件、毫秒阈值及监测命令。
- Redis:Diagnosing latency issues——fork、持久化与系统层延迟。
- Redis:INFO——持久化和统计字段。
- Redis:Persistence——RDB、AOF 与后台保存的取舍。
- Redis:CLI——命令行客户端与延迟采样。