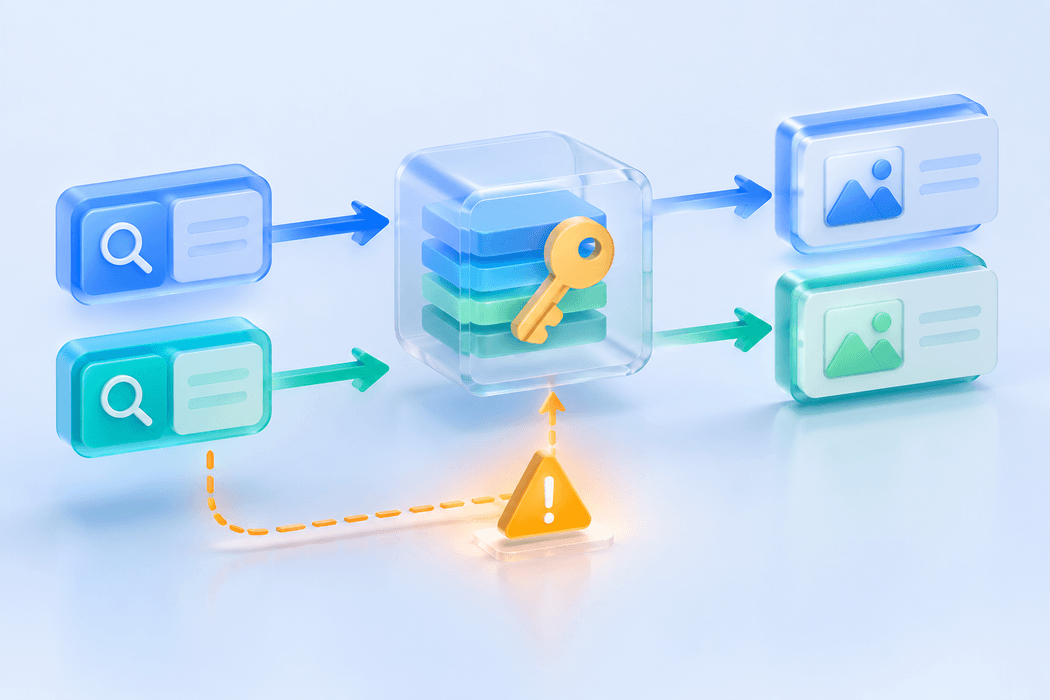
搜索“服务器”能看到结果,换成“证书”却还是同一批文章;分页地址已经变成第二页,内容仍停在第一页。接入 CDN 后出现这种现象,值得检查不同请求是否被当成了同一个缓存对象。
尤其是启用了 HTML 缓存、忽略查询参数或自定义缓存键的站点,URL 看起来不同,不代表缓存层真的把它们区分开了。但串页也可能来自源站页面缓存、应用查询或前端接口,不能看到 CDN 就直接认定节点有故障。
本文以公开 GET 搜索页和筛选页为主。示例地址与参数均为占位,不代表任何网站的实测结果。账户、订单和个人化搜索等内容,应先确认隐私边界,再决定是否允许共享缓存。
先区分三个独立设置
诊断时需要分别确认:请求是否允许缓存、什么信息参与缓存键、哪些参数会传给源站。这三件事可能由不同规则控制。
缓存键用于判断一个已有响应能否复用给当前请求。如果源站根据 q 生成不同搜索结果,而缓存键忽略 q,第一份被保存的结果就可能被复用给其他关键词。
参数转发则决定源站收到什么。即使缓存键区分了 q,如果回源时把 q 删除,源站仍可能对不同请求返回同一份默认页面。反过来,源站收到了完整参数,也不代表边缘缓存键包含这些参数。
不同 CDN 产品默认行为不同。CloudFront 将缓存策略与源站请求策略分开配置;Cloudflare 的缓存键及查询参数规则也受具体功能、规则顺序和套餐能力影响。不能把“CDN 默认忽略参数”当作通用结论。
哪些参数会改变页面内容
先整理一份参数用途清单。下面只是判断示例,不是可以直接导入的规则:
| 参数类别 | 示例 | 检查重点 |
|---|---|---|
| 搜索关键词 | q、s | 是否影响结果集合 |
| 页码与排序 | page、paged、sort | 是否改变当前页或顺序 |
| 筛选与语言 | category、lang | 是否改变内容范围和语言 |
| 营销标记 | utm_source | 应用是否确实不依赖它 |
| 身份或签名 | token、signature | 是否应直接禁止共享缓存 |
参数名称由应用决定。对某个站点无意义的参数,在另一个系统里可能参与内容生成。即使 utm_source 通常只用于归因,也应确认它不会触发不同活动页面或个性化逻辑。
同时检查路径、主机名、Cookie、请求头和地理位置是否影响响应。只把查询参数加入缓存键,并不能解决所有内容变化维度。
URL 片段如 #section 通常不会随 HTTP 请求发给服务器,不能把它当作服务端缓存隔离条件。前端应用可能在浏览器里根据片段渲染,这需要单独检查脚本行为。
用两组固定请求复现,不靠随机参数
选择两组结果应当明显不同的公开查询,用不带登录 Cookie 的请求保存响应。例如在 Linux 或 macOS 终端:
curl -sS -L --max-time 30 -D alpha.headers -o alpha.html \
  'https://example.com/search/?q=alpha&page=1'

curl -sS -L --max-time 30 -D beta.headers -o beta.html \
  'https://example.com/search/?q=beta&page=1'
域名、路径和参数需要替换为实际公开入口。引号用于避免 shell 将 & 解释为后台执行符;不能直接去掉。
再重复请求相同的两组 URL,对照结果标题、页码和服务商缓存状态字段。Age、Cache-Control、Vary 可以辅助判断,但状态头名称和含义应以产品文档为准。
整个 HTML 的哈希不适合作为唯一证据。随机标记、时间或安全令牌可能让内容每次不同;反过来,两种关键词没有匹配结果时,返回同一空结果页也可能完全正常。应检查与查询语义相关的字段。
这些 curl 请求不执行 JavaScript。如果 HTML 是空壳,实际结果来自接口,应检查开发者工具里那条真实接口请求的 URL、参数和响应。只盯着入口 HTML 的缓存,可能找错对象。
不要用持续添加随机参数的方法验收。规则可能忽略参数,也可能制造大量新缓存条目,原 URL 的问题仍然保留。
沿着边缘、源站缓存和应用逐层比较
通过主机或 CDN 提供的受控诊断路径比较源站输出,保留正确的域名、协议和访问保护。不要为了测试临时公开源站,也不要关闭 TLS 校验。
如果源站对两组关键词返回正确且不同的结果,边缘却返回相同旧内容,重点检查 CDN 缓存资格、缓存键与规则优先级。
如果源站本身也串页,继续看反向代理、WordPress 页面缓存或应用缓存。CDN 即使正确区分 URL,也可能只是把源站返回的错误页面分别保存下来。
如果接口响应正确、页面显示错误,则检查前端状态更新、请求竞争和本地缓存。快速切换关键词时,较慢的旧请求可能覆盖新结果,这与边缘缓存键没有直接关系。
还要注意重定向。搜索入口可能先跳到标准地址,途中丢掉参数;此时最终请求已经相同。带 -L 的诊断应同时检查每一跳的 Location 与最终地址。
临时恢复可先限制动态页面缓存
如果公开搜索页正在大范围串页,可以在获批准的变更窗口,对明确的搜索路径或参数条件设置临时绕过,并定向清理受影响条目。记录原规则、优先级和回滚方式。
绕过会增加回源,需观察源站负载。大站应控制范围,避免因全站停用缓存造成新的可用性问题。
长期配置有两类常见选择:对低复用、高变化的搜索页不做共享缓存;或只缓存经过评估的公开查询,并让影响响应的参数参与缓存键。两种方案都需要与应用一致。
对匿名且完全公开的搜索结果,短时间缓存可能有价值;对用户专属、带权限过滤或敏感条件的结果,通常应避开公共共享缓存。private 与 no-store 等响应语义应结合实际产品配置核实,不能假定覆盖上游头的强制缓存规则会自动保护这些内容。
Vary 表示按请求头选择响应,不是把 URL 参数加入缓存键的通用指令;不同 CDN 对 Vary 的支持也可能有限。查询参数应通过相应缓存策略管理。
参数归一化必须保留应用语义
有些产品可以排序参数、忽略特定参数或只纳入白名单。这能减少无意义的缓存碎片,但前提是归一化不会改变业务含义。
例如 ?q=alpha&page=2 与 ?page=2&q=alpha,在多数普通表单中可能含义相同;对于签名校验、重复参数或依赖原始顺序的系统,就不能直接套用这个假设。
重复参数 ?tag=a&tag=b 也要检查框架如何解析。缓存层若按一种规则归一化,应用却按另一种规则读取,就可能出现错误复用,甚至形成缓存投毒风险。
使用参数白名单时,还需要确认新增功能参数的上线流程。新筛选条件已被应用识别,但尚未加入缓存键,可能在发布后立即造成串页。规则变更应与应用发布一起验收。
签名 URL、鉴权参数和私有数据更需要按产品的原生安全方案处理。把令牌纳入缓存键不能自动证明安全,也可能增加日志和缓存元数据中的敏感信息暴露。
改规则后仍要处理旧条目
缓存键或缓存资格变更,不应被视作已经完成所有旧缓存清理。根据产品机制确认规则生效范围、传播状态和旧对象处理方式,必要时定向刷新相关 URL 及变体。
如果内层页面缓存仍错误,先修好内层再刷新外层,否则节点会再次取回错误内容。涉及全站清理时,要评估回源峰值与预热成本。
保留原配置和测试矩阵,分批应用变更。出现回源负载异常或命中率大幅下降时,可以回滚本次规则,但回滚之后仍需核实已经生成的缓存对象,不能只看控制台显示“已恢复”。
验收既看首次响应,也看缓存命中
至少覆盖两种关键词、两个页码,以及业务实际使用的排序或语言条件。每组先请求一次,再重复请求,确认后续命中没有把不同结果合并。
还应比较匿名态与登录态,使用测试账号确认个人化内容不会复用给其他用户。不要用真实客户数据做跨账号缓存试验。
记录 URL、预期结果、响应中的业务标识、缓存状态和规则版本。最后再用浏览器走一遍真实搜索流程,确认前端接口与 HTML 的策略一致。
这类故障修复后,应把“哪些信息会改变响应”加入应用发布清单。搜索参数、筛选字段或权限逻辑发生变化时,同时复核缓存键,才能减少串页再次出现。
参考资料
核验日期:2026-11-03。以下为官方产品文档与 MDN HTTP 资料;具体规则能力和默认值以正在使用的产品配置为准。