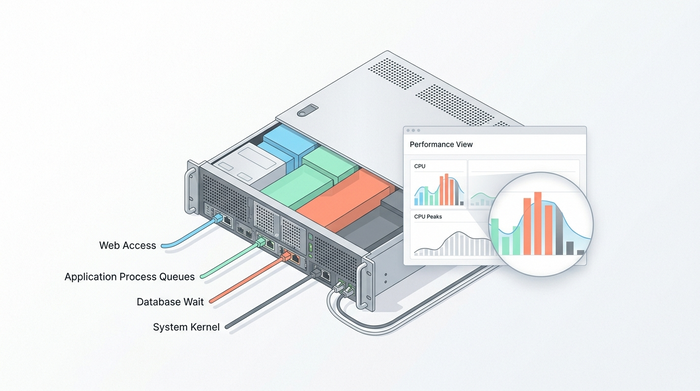
Linux 服务器 CPU 使用率飙到 80% 或 90% 以上,网站却还能打开,这种情况比直接宕机更容易误判。页面偶尔能返回,说明链路没有完全断开,但队列、响应时间和连接数可能已经在恶化。本文按实际排查顺序,拆开 %us、%sy、%wa、%si、%st 的含义,并分别定位 Java、PHP-FPM、Nginx 和内核线程的占用来源。
排查思路是:先确认 CPU 高出现在哪个时间窗口和哪个逻辑核,再找到具体进程和线程,最后判断属于业务计算、锁等待、进程频繁创建、网络中断、虚拟化资源争抢还是内核回收。不要一看到 CPU 高就重启服务器,现场被清掉后往往只能等下一次故障。
一、先看 top 的 CPU 行
登录服务器后先用 top 或 vmstat 建立观察窗口:
top
vmstat 1
top 展开后的 CPU 行里,这些字段比总使用率更有信息量:
%us:用户态 CPU,通常来自 Java、PHP、Python、Node.js 等业务进程。%sy:内核态 CPU,常见于频繁系统调用、进程创建、内存回收、锁竞争、网络包处理。%wa:等待磁盘 I/O,不算真正消耗计算能力,但会让请求变慢。%si:软中断,常见于高网络包速率、小包过多或网卡队列分布不均。%st:虚拟化环境被宿主机抢走的时间,云服务器上要特别留意。
网站还能打开但 %us 很高,优先查业务进程。%sy 高则看系统调用、进程、线程和内存活动。%si 高看网络包和网卡队列。%st 高说明瓶颈可能不在虚拟机内部,需要检查云监控、实例规格和宿主机争抢。
top 里按数字 1 可以展开每个逻辑核。如果只有一个核跑满,其他核空闲,常见原因是单进程或单线程瓶颈、中断集中在某个核、绑核配置不合理。所有核同时高,则更像是请求量、扫描、重计算或整体容量不足。
二、确定是哪个进程
先用 top 按资源排序,再配合 pidstat 做连续采样:
top -H -d 2
pidstat -u 2 5
如果系统没有 pidstat,Debian 或 Ubuntu 可以安装 sysstat,CentOS Stream、Rocky Linux、AlmaLinux 同样通常由 sysstat 软件包提供。安装前遵守公司或云服务器的变更规则。
找到可疑进程后,把 PID 交给 /proc 和命令行确认:
readlink /proc/
tr '\0' ' ' < /proc/
ps -eo pid,ppid,user,stat,pcpu,pmem,etime,cmd –sort=-pcpu | head -30
exe 能确认二进制路径,cmdline 能看到启动参数。两者与预期不一致时,不要直接杀进程,先确认是否属于计划任务、监控 Agent、备份任务或安全软件。
三、Java 进程:从线程栈找热点
Java 服务经常表现为 %us 高、网站仍能响应但接口延迟明显。先用 top 找到 Java 线程号,再把线程号转成十六进制:
printf '%x\n'
jstack
jstack 输出里重点看 RUNNABLE 线程在做什么:JSON 序列化、正则匹配、加密解密、大集合遍历、GC 线程高频运行,都会让用户态 CPU 升高。如果线程大量处于 BLOCKED,CPU 可能不高但延迟很高;此时要查锁持有者,而不是盲目加 CPU。
再结合 GC 日志和 JVM 统计:
jstat -gcutil
Young GC 或 Full GC 频繁、Old 区回收后占用仍然很高,CPU 高可能是内存分配压力的表现。此时扩容 CPU 只能缓解表象,真正要处理的是对象分配、缓存无界增长、堆设置和查询量。
Java 16+ 提供 jfr 采样。生产环境采样要控制时长和频率,先使用短窗口采样,把影响控制在小范围内。容器里的 Java 进程还要确认可见 CPU 和内存限制,避免 JVM 按宿主机资源推断默认参数。
四、PHP-FPM:先看进程状态和慢日志
PHP 站点的高 CPU 常与请求阻塞叠加出现。先用进程管理接口确认 worker 状态:
curl -s http://127.0.0.1/status | head -50
重点看 active workers、idle workers、listen queue 和 max children reached。active 满且 listen queue 增长,说明请求已经排队;此时 CPU 高可能是 worker 全部忙,也可能是少数慢请求拖住了进程池。
再打开 PHP-FPM 慢日志。request_slowlog_timeout 通常设置成能捕获异常请求但不会把整个进程池打满的值,例如 3s 或 5s,具体要按接口耗时分布调整:
slowlog = /var/log/php-fpm/www-slow.log
request_slowlog_timeout = 3s
慢日志里的脚本路径和行号只是入口,还要继续查外部 HTTP 调用、数据库查询、图片处理和循环。pm.max_children 不是越大越好,超过内存和 CPU 承载能力后,站点会从排队变成重启。
五、Nginx:区分进程忙和连接堆积
Nginx 自身 CPU 高相对少见,更多时候是连接、TLS 握手、日志和代理转发带来的系统性开销。先看状态:
nginx -T | grep -E 'worker_processes|worker_connections|access_log|gzip'
ss -s
如果 access log 记录了大量扫描请求、TLS 握手和小文件请求,CPU 可能被低价值流量消耗。gzip 对文本压缩会带来额外 CPU,静态大文件适合前置到 CDN 或对象存储,而不是每次都由源站压缩。
高并发下可以检查 worker 数与逻辑核数量是否匹配。通常 auto 是合理默认值,绑核和优化要结合实际负载做,不要照抄模板。开启 $request_time、$upstream_response_time 和 $upstream_addr 记录,能区分 Nginx 自身忙还是后端慢。
六、内核和系统线程的 CPU 占用
%sy 或 %si 高时,top 里可能出现 ksoftirqd、kworker、kswapd 等内核线程。它们不是独立故障源,而是某种内核活动的表现。
ksoftirqd 高通常看网络中断分布:
cat /proc/interrupts
ss -s
如果网卡队列集中在一个逻辑核,高流量时会造成单核跑满。云服务器上能调整的范围有限,可以从减少小包、限制扫描流量、开启缓存、检查负载均衡转发模式入手。
kworker 高可以结合 I/O 和内存活动看:
vmstat 1
iostat -x 1
常见诱因是磁盘压力大、频繁写日志、备份任务碰上流量高峰。kswapd 高则说明内存紧张,系统在频繁回收页面。直接内存回收还会推高 %sy,此时重点查内存和无缓存命中率,而不是继续加 CPU。
七、把外部依赖也纳入排查
应用进程 CPU 高,不一定是代码计算多。数据库慢查询、外部 API 慢、连接池耗尽、反复重连,都会让业务线程忙等、序列化和重试增加。至少把这些日志放到同一个时间窗口:
- Nginx access log 的状态码、请求耗时、上游耗时。
- 应用错误日志和结构化日志。
- 数据库慢查询日志或云数据库监控。
- CDN 回源监控和云服务器网络监控。
如果 CPU 升高时间点与定时备份、日志压缩、病毒扫描、发布上线重合,优先检查计划任务。可以用下面的命令看近期任务:
grep 'cron' /var/log/syslog | tail -100
systemctl list-timers –all
八、修复时要避免的做法
这几类操作容易把问题放大:
- CPU 高就重启服务器,丢失进程队列、线程栈和日志现场。
- 只看平均 CPU,不看单核分布和
%sy、%wa、%st。 - 无容量依据地调大 worker、线程池或连接池。
- 关闭安全软件、监控 Agent 或内核机制来“降 CPU”。
- 在生产高峰期做大规模配置试验。
修复顺序应该是:先限流或摘掉异常流量,保留日志;再定位到进程和线程;确认是应用、数据库、内核还是资源限制;最后扩容或优化。每次只改一个变量,并记录变更时间,方便后续用监控对齐。
九、验证恢复
处理完成后,不要只看一次 top。至少确认五个指标:
- CPU 使用率回到正常基线,单核不再长期 100%。
%wa、%si、%st没有新的异常。- HTTP 状态码、5xx 比例和 P95 延迟恢复正常。
- 应用队列、连接池、数据库活跃连接回落。
- 日志中没有持续增加的错误、重启或 OOM 记录。
观察时间要覆盖一个流量高峰或一个定时任务周期。CPU 飙高如果只在凌晨备份、定时发布或爬虫集中访问时出现,短时间采样会漏掉根因。
结论
CPU 飙高但网站还能打开,说明系统仍在服务,但容量余量已经被吃掉。先用 top、vmstat 和 pidstat 分清用户态、内核态、I/O 等待、软中断和 steal,再定位到 Java 线程、PHP-FPM worker、Nginx 请求或内核活动,最后结合 Nginx、应用、数据库和云监控的时间线判断根因。保留现场、单变量调整、覆盖高峰验证,比盲目重启更容易把问题真正收掉。
参考资料
Linux man-pages:top(1)
https://man7.org/linux/man-pages/man1/top.1.html
Linux man-pages:vmstat(8)
https://man7.org/linux/man-pages/man8/vmstat.8.html
sysstat 文档:pidstat(1)
https://man7.org/linux/man-pages/man1/pidstat.1.html
OpenJDK 文档:jstack 命令
https://docs.oracle.com/en/java/javase/21/tools/jstack.html
OpenJDK 文档:jstat 命令
https://docs.oracle.com/en/java/javase/21/tools/jstat.html
PHP-FPM 配置:request_slowlog_timeout
https://www.php.net/manual/en/install.fpm.configuration.php
NGINX 文档:Core functionality
https://nginx.org/en/docs/ngx_core_module.html